Qué pasó con los servicios de Microsoft 365
Microsoft afirma que un error de software introducido en julio provocó la interrupción de Microsoft 365 a nivel mundial la semana pasada, desencadenando un fallo en cascada que dejó inoperativos más del 80% de sus servidores de puerta de enlace (gateway) de red. La interrupción, que duró casi 24 horas el 12 de noviembre, afectó a los servicios de Microsoft 365 en todo el mundo —incluidos Outlook, Exchange Online, Teams y Copilot—, impidiendo que los usuarios accedieran a su correo electrónico y provocando retrasos significativos en la entrega de mensajes. En un informe preliminar posterior al incidente, compartido en el Centro de administración de Microsoft 365, la empresa señaló que la interrupción fue causada por tres factores: un error de software previamente no detectado, un aumento del tráfico tras un proceso de conmutación por error (failover) en Microsoft Teams y una capacidad reducida de los servidores. El incidente comenzó a las 11:20 a. m. (hora del Este) del jueves 12 de noviembre y se prolongó hasta las 11:10 a. m. (hora del Este) del día siguiente, momento en el que Microsoft confirmó que los servicios se habían restablecido por completo.
Según Microsoft, el error de software se introdujo en julio a través de una actualización desarrollada para los servidores de puerta de enlace de red de Microsoft 365. Aunque la actualización llevaba más de tres meses implementada sin problemas, contenía un fallo que podía sobrecargar los servidores bajo determinadas condiciones de tráfico, provocando que dejaran de responder.
Microsoft explica que sus pruebas de la actualización no detectaron el error, ya que se utilizó hardware de prueba menos potente que el empleado en los servidores de producción.
"Nuestras pruebas de carga habituales no detectaron el problema latente debido a la combinación de tráfico y a las configuraciones de hardware (SKU) utilizadas en nuestros laboratorios", detalló Microsoft en su informe preliminar. "El problema de contención se agrava en máquinas con más núcleos y hardware más reciente; sin embargo, nuestras pruebas de carga solían centrarse en hardware menos potente y con menos núcleos".
El error se desencadenó finalmente después de que Microsoft Teams cambiara automáticamente a la infraestructura de red utilizada por Exchange Online —aproximadamente 15 horas antes de la interrupción—, lo que aumentó el tráfico en dichos servidores.
Microsoft Teams también sufrió una interrupción independiente ese mismo día, aunque no está claro si ambos incidentes están relacionados.
Para complicar aún más la situación, Microsoft indica que cerca del 14% de la capacidad de los servidores de puerta de enlace ya estaba fuera de servicio debido a un problema no relacionado. Si bien la infraestructura contaba con capacidad suficiente para gestionar la reducción, la combinación de un mayor tráfico y una capacidad disminuida desencadenó un error de software.
A medida que los servidores dejaron de responder, los sistemas de Microsoft redirigieron a los usuarios a otros servidores disponibles; estos, a su vez, se vieron desbordados por el tráfico adicional y también fallaron.
"En menos de dos horas, el defecto —hasta entonces desconocido— se manifestó en toda nuestra infraestructura, dejándola inoperativa. En el punto crítico, más del 80% de los servidores dejaron de responder", explicó Microsoft.
Microsoft señala que los mecanismos de seguridad, diseñados para evitar que los problemas se propaguen entre regiones, tampoco lograron contener las interrupciones en cadena, lo que permitió que el fallo se extendiera a nivel mundial.
Mientras que otros servicios de Microsoft 365, como Teams, OneDrive y SharePoint, pudieron migrar a una infraestructura alternativa y recuperarse antes, Exchange Online no pudo realizar dicho cambio, lo que impidió a los usuarios acceder a sus buzones de correo. Microsoft indica que la recuperación resultó compleja, ya que, al reiniciar los servidores afectados, estos volvían a verse rápidamente desbordados por el tráfico acumulado.
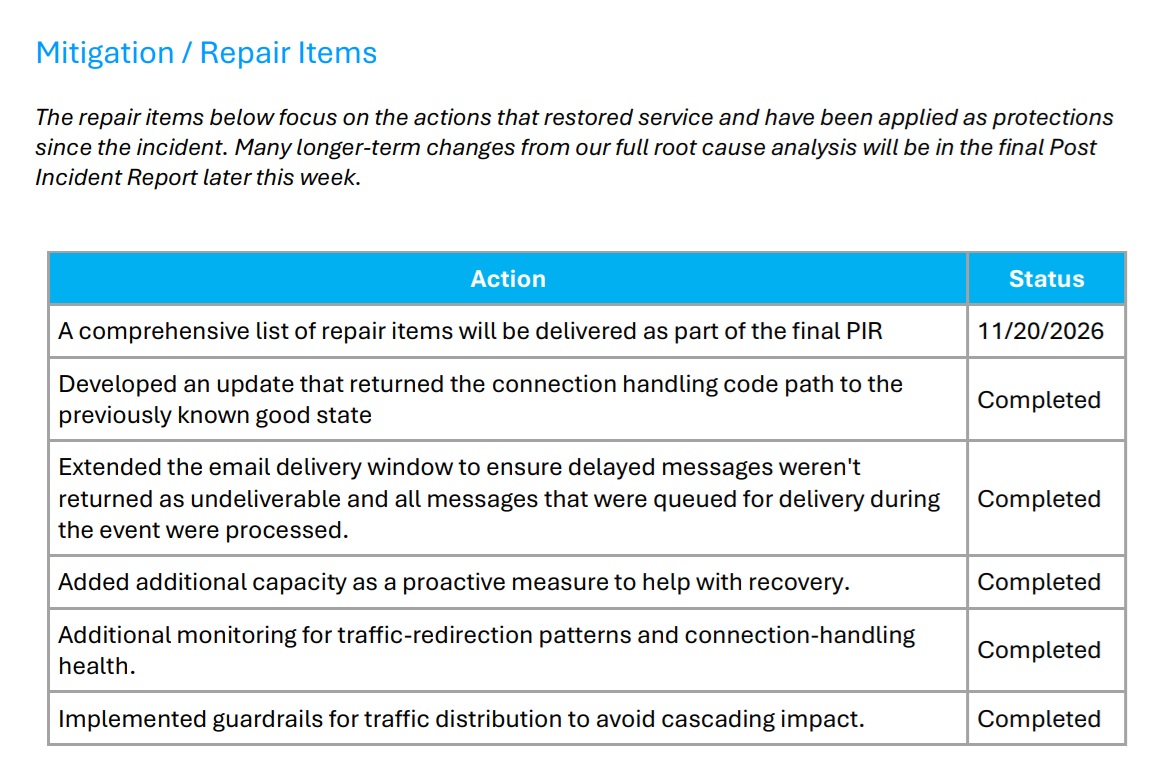
Tras identificar el error, los ingenieros de Microsoft desarrollaron una solución y la implementaron en los servidores afectados, lo que permitió estabilizar los servicios a lo largo del viernes. Microsoft confirmó que el impacto en los usuarios había cesado a las 11:10 a. m. (hora del Este) del 13 de noviembre.
La compañía afirma que, desde entonces, ha aumentado la capacidad, mejorado la supervisión y añadido medidas de seguridad para evitar que la redirección de tráfico provoque fallos en cadena similares.
Microsoft informa que la investigación continúa y que se espera publicar un informe final sobre el incidente a finales de esta semana.